
¿Cómo probar una función de IA antes de que el equipo dependa de ella?
Una función de IA puede dar respuestas convincentes en una demostración y, aun así, tener dificultades con el trabajo diario. Antes de que el equipo dependa de ella, acuerden qué aspecto tiene un resultado útil, prueben preguntas realistas con alguien que conozca el trabajo y usen los fallos para decidir qué está listo.
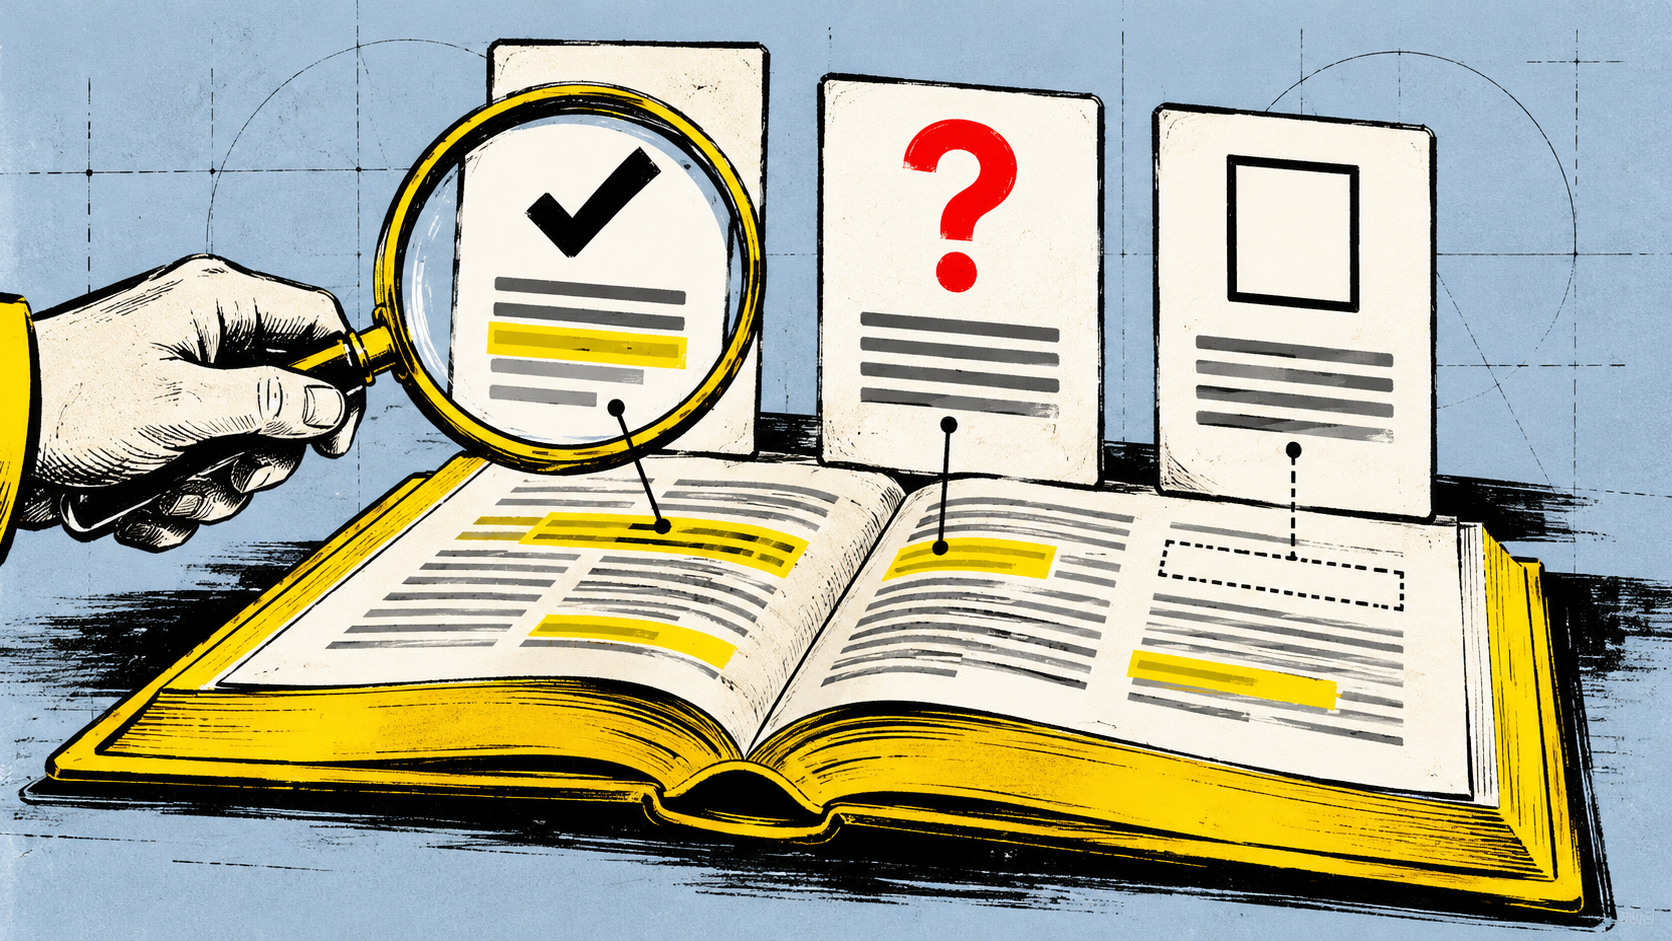
Un prototipo responde bien a unas cuantas preguntas. Ahora alguien quiere ponerlo a disposición del equipo. Antes de aceptar, pide al proveedor que muestre cómo resuelve el trabajo que esas personas realmente le encargarán, incluidas las preguntas que no puede contestar.
Puedes concretar bastante la conversación. Elige una tarea, acuerda qué aspecto tiene un resultado útil y revisa una serie de ejemplos realistas con alguien que conozca el trabajo. Así tendrás una base para decidir si se puede lanzar.
Empieza por una tarea y sus límites
Imagina una función que prepara respuestas preliminares a partir de directrices internas aprobadas. Una persona del equipo lee cada borrador antes de usarlo. Es un ejemplo hipotético, pero ayuda a entender mejor qué significa aceptar el resultado.
Anota qué fuentes puede utilizar la función, para quién está pensada y qué produce. En este ejemplo, redacta una respuesta usando las directrices que esa persona tiene permiso para consultar. Enviar la respuesta o modificar un registro serían capacidades distintas que habría que probar.
Después, acuerda qué se considera útil. El borrador debe responder a la pregunta, ajustarse al material aprobado, conservar las condiciones relevantes e indicar qué fuente lo respalda. Si el material no permite responder, debe decirlo. Reconocer con claridad que falta información puede ser un buen resultado.
Una regla inventada, la omisión de una condición que cambia la respuesta o una respuesta segura de sí misma basada en directrices equivocadas harían que el borrador no sirviera. Acuerda estas diferencias antes de revisar los resultados. De lo contrario, una respuesta fluida puede resultar sorprendentemente convincente.
Prueba las preguntas que la gente hará de verdad
Para el ejemplo de las respuestas preliminares, incluye al menos estas situaciones:
- Una pregunta habitual. Las directrices contienen una respuesta clara. ¿El borrador la recoge con precisión e indica la fuente correcta?
- Una pregunta ambigua. Podrían aplicarse dos procedimientos. ¿La función pide el dato necesario para elegir, en vez de decidirse por uno sin avisar?
- Falta información. Las directrices aprobadas no cubren la solicitud. ¿La función explica qué falta y deja que una persona resuelva la respuesta?
Estos ejemplos son un punto de partida. Prepara el conjunto de pruebas para reflejar el trabajo real: solicitudes frecuentes, información incompleta, expresiones difíciles y errores cuyas consecuencias importan. Utiliza datos representativos autorizados o ejemplos preparados de forma segura, y no introduzcas registros confidenciales en servicios que no estén aprobados.
La guía de evaluación de Microsoft recomienda usar interacciones representativas y casos difíciles. Para una persona responsable, la pregunta útil es si los ejemplos cubren las situaciones en las que el equipo necesita ayuda. Una prueba general de modelos no puede resolver esa cuestión para tu aplicación.
Pide a alguien que conozca el trabajo que valore los resultados
Pide a alguien familiarizado con la tarea que revise las respuestas según los criterios acordados. Debe poder explicar por qué una respuesta sirve, es incorrecta o genera dudas. Conviene una segunda revisión cuando haya desacuerdo o las consecuencias de un error sean importantes.
El Marco de Gestión de Riesgos de la IA de NIST, de aplicación voluntaria, respalda las pruebas documentadas, las condiciones parecidas a las del uso real y la participación de especialistas pertinentes. Es una referencia útil para preguntar qué se probó y quién lo revisó. No establece una nota mínima universal para tu función.
Deja algunos ejemplos de evaluación aparte de los que se usan para mejorar la función. Si el proveedor la ajusta una y otra vez con cada pregunta de prueba, sabrás lo bien que resuelve esas preguntas conocidas. Los ejemplos separados permiten comprobar mejor cómo se desenvuelve con tareas para las que no se ha ajustado.
La puntuación automática puede ayudar a ordenar los resultados, pero también hay que revisar sus valoraciones. Las personas pueden pasar por alto errores, y una IA que evalúa a otra IA también puede equivocarse. Pide ver respuestas concretas y los motivos de las puntuaciones.
Examina los fallos que se esconden tras el promedio
Una puntuación global puede ayudar a comparar versiones. Además, pide ver los resultados agrupados por las situaciones y los errores relevantes. Puede que las preguntas habituales salgan bien, mientras que las preguntas sin fuente provoquen respuestas inventadas una y otra vez. El promedio oculta una decisión que tienes que tomar sobre ese uso concreto.
Anota qué fallos se produjeron, su gravedad y qué sigue siendo incierto. Decide cuáles impiden el uso previsto. El nivel de error aceptable depende de la tarea y de lo que ocurra después de un fallo; no hay un porcentaje que sirva para todas las empresas.
Si la función también ejecuta acciones, comprueba qué ocurrió realmente en el sistema conectado. Por ejemplo, si dice que actualizó un registro, verifica que sea el registro correcto y que tenga el valor previsto. El análisis de Anthropic de enero de 2026 sobre la evaluación de agentes de IA explica por qué importa el resultado final cuando el software actúa. Un mensaje que diga que la tarea ha terminado no demuestra que se haya completado correctamente.
La calidad de las respuestas es solo una parte de la aceptación. La seguridad, los permisos, la privacidad y el resto del flujo de trabajo requieren sus propias comprobaciones. Una buena puntuación en las respuestas no demuestra que esos otros aspectos funcionen.
Concreta la decisión de lanzamiento
Pide al proveedor un breve informe que indique la tarea y sus límites, los casos de prueba y los resultados esperados, quién los revisó, los fallos importantes, las dudas pendientes y la versión probada. Incluye el modelo, las instrucciones, el material de origen y el software conectado cuando afecten al resultado. Acuerda qué pruebas deben repetirse si cambia cualquiera de esos elementos.
Las pruebas deben servir para tomar una de estas tres decisiones:
- Aprobar un uso limitado. Los resultados respaldan una tarea concreta dentro de unos límites definidos. El equipo sabe cuándo revisar, detenerse o volver al proceso actual.
- Corregir y volver a probar. Hay que resolver fallos concretos. Acordad qué casos se repetirán y qué ejemplos independientes comprobarán que la corrección funciona.
- Aplazar el lanzamiento. Quedan fallos importantes sin resolver o las pruebas disponibles son demasiado escasas para respaldar el uso propuesto.
Una prueba piloto limitada puede aportar datos de trabajo real. Define de antemano quién participará, qué tareas hará, qué permisos tendrá, cómo se revisarán los resultados y cuál será el procedimiento alternativo. Asigna a alguien la responsabilidad de vigilar los problemas y detener la prueba si hace falta. Un buen resultado en una prueba pequeña respalda ese uso limitado, pero no demuestra una fiabilidad general.
Al terminar la conversación sobre la aceptación, deberías saber en qué puede confiar el equipo, cuándo todavía debe decidir una persona y qué situación obligaría a repetir las pruebas. Si estás planificando una función de IA para una aplicación empresarial a medida, podemos hablar de la tarea que quieres resolver y de las pruebas que necesitarías antes de aceptarla.